RAG-System aufbauen: Architektur, Kosten und typische Fehler
Joshua Heller · 14. Oktober 2026 · 12 min.
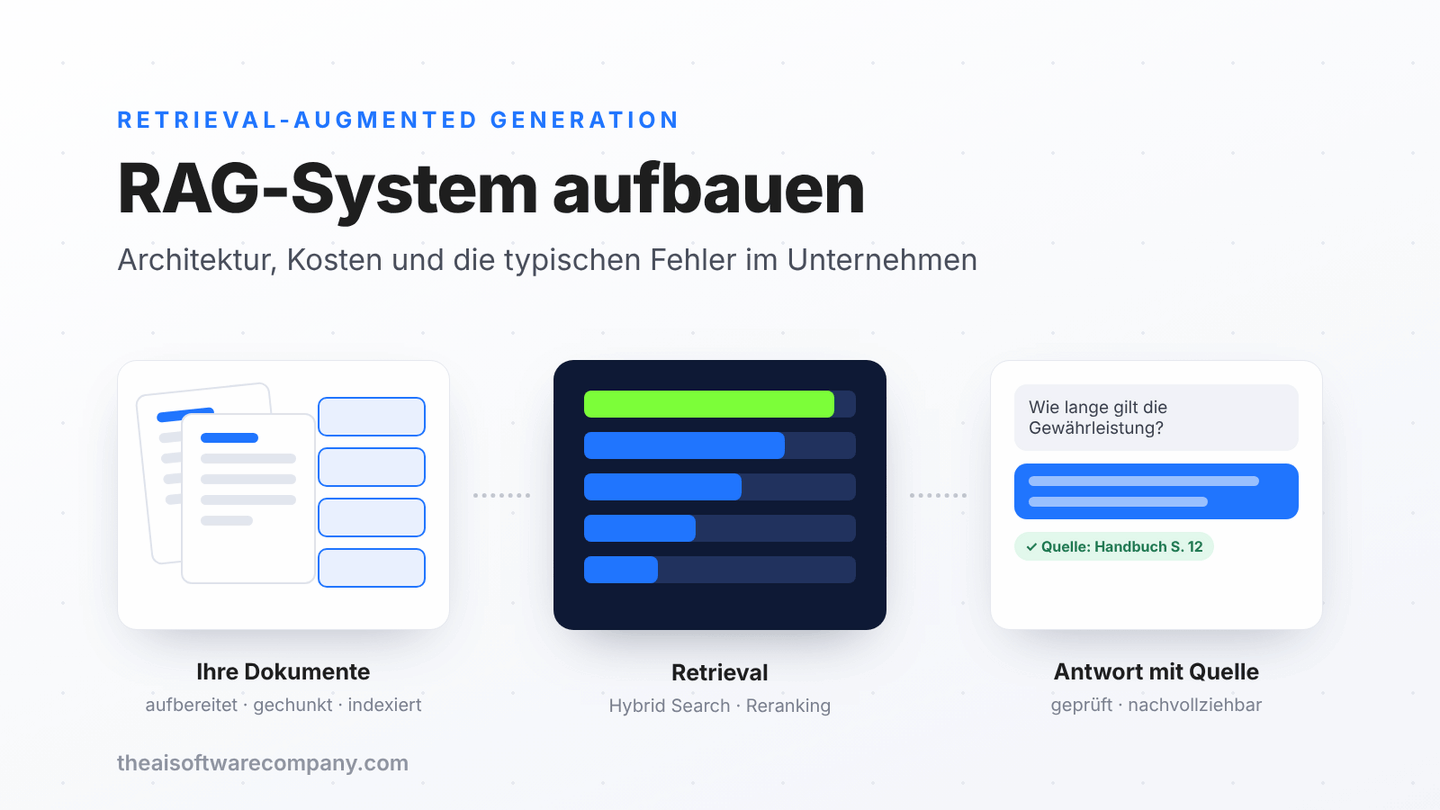
Ein RAG-System (Retrieval-Augmented Generation) ist eine KI-Anwendung, die zu jeder Frage zuerst die passenden Stellen aus Ihren eigenen Dokumenten heraussucht und das Sprachmodell nur auf dieser Grundlage antworten lässt, mit Quellenangabe. So nutzt ein Chatbot oder KI-Agent Firmenwissen, ohne dass ein Modell mit Ihren Daten trainiert werden muss. Ob das System gut wird, entscheidet dabei selten das Modell, sondern die Architektur drumherum: Aufbereitung der Dokumente, Suche, Rechte und Tests.
Wir bauen bei TAISC in Karlsruhe RAG-Systeme für den Mittelstand, vom internen Wissens-Chatbot bis zur Fehleranalyse im IT-Support, und haben im September 2026 eine zweitägige Advanced-Schulung zu RAG gegeben. In diesem Beitrag zeigen wir, wie ein RAG-System aufgebaut ist, was es kostet, wann Sie gar keins brauchen und an welchen Fehlern die meisten Projekte scheitern.
Was ist ein RAG-System?
Ein großes Sprachmodell (LLM) kennt das öffentliche Wissen aus seinem Training, aber nicht Ihre Handbücher, Richtlinien, Verträge oder Support-Tickets. Fragt man es trotzdem danach, rät es, und zwar überzeugend. Diese Halluzinationen sind der Hauptgrund, warum ein reiner Chat-Zugang im Unternehmen schnell an Grenzen stößt.
RAG löst das Problem, indem es die Arbeit aufteilt. Eine Suchkomponente, das Retrieval, findet die relevanten Textstellen in Ihrem Bestand. Das Sprachmodell bekommt diese Stellen zusammen mit der Frage und formuliert daraus die Antwort, die Generation. Der Begriff stammt aus einem Forschungspapier von Lewis und Kollegen bei Facebook AI Research aus dem Jahr 2020. Heute ist RAG das Standardmuster, wenn KI mit Unternehmenswissen arbeiten soll, und steckt auch hinter vielen „Chat mit Ihren Dokumenten“-Funktionen großer Anbieter.
Drei Eigenschaften machen RAG im Unternehmen attraktiv:
- Aktualität: Ändert sich ein Dokument, wird es neu indexiert. Kein Modell muss neu trainiert werden.
- Nachvollziehbarkeit: Jede Antwort kann die Stellen nennen, auf denen sie beruht. Nutzer können prüfen, statt zu glauben.
- Kontrolle: Die Daten bleiben in Ihrem System. Sie entscheiden, welche Quellen angebunden sind und wer was sehen darf.
Genau diese Punkte bremsen laut Bitkom den KI-Einsatz in Deutschland: In der Befragung von 604 Unternehmen (Bitkom Research 2025, Studienbericht Februar 2026) nennen 48 Prozent die Anforderungen an den Datenschutz als Hemmnis, 39 Prozent sorgen sich, dass Unternehmensdaten in falsche Hände geraten, und 38 Prozent bemängeln die fehlende Nachvollziehbarkeit von Ergebnissen. Ein sauber gebautes RAG-System adressiert alle drei.
Wie funktioniert eine RAG-Pipeline?
Eine RAG-Pipeline besteht aus zwei Teilen: der Indexierung, die einmalig und bei jeder Änderung läuft, und der Abfrage, die bei jeder Frage läuft.
Indexierung:
- Laden und aufbereiten. Dokumente werden aus den Quellsystemen geholt und in sauberen Text umgewandelt, inklusive Tabellen, Überschriften und Seitenzahlen. Bei PDFs ist das der unterschätzteste Schritt.
- Zerteilen. Der Text wird in Abschnitte zerlegt, das Chunking. Gute Chunks sind inhaltlich abgeschlossen und tragen ihren Kontext mit, etwa den Pfad der Überschriften.
- Einbetten. Jeder Chunk wird per Embedding in einen Zahlenvektor übersetzt, der seine Bedeutung abbildet. Ähnliche Inhalte liegen dann nah beieinander, auch wenn sie andere Wörter benutzen.
- Speichern. Vektoren, Text und Metadaten wie Quelle, Datum und Berechtigungen landen in einer Vektordatenbank.
Abfrage:
- Die Frage wird ebenfalls eingebettet, oft vorher umformuliert oder in Teilfragen zerlegt.
- Die Suche liefert die ähnlichsten Chunks, idealerweise kombiniert aus Vektorsuche und klassischer Stichwortsuche.
- Ein Reranker sortiert die Kandidaten nach tatsächlicher Relevanz und behält nur die besten.
- Das Sprachmodell bekommt Frage und Chunks und antwortet mit Quellenangaben, oder sagt ehrlich, dass die Unterlagen die Frage nicht beantworten.
Wie Embeddings in der Praxis funktionieren, haben wir zuerst in unserem eigenen AI News Digest gelernt. Der Agent bettet die Newsletter einer Woche ein und fasst Texte mit einer Kosinus-Ähnlichkeit über einem festen Schwellenwert zu einem Thema zusammen. Drei Newsletter über dieselbe Meldung werden so zu einem Eintrag. Das ist dasselbe Prinzip, mit dem ein RAG-System zu einer Frage die passenden Abschnitte findet, und es hat uns gezeigt, warum wir Inhalte nicht direkt vom Sprachmodell gruppieren lassen: Die Ergebnisse sind schwerer vergleichbar und schwerer zu prüfen.
RAG-Architektur: Die Bausteine im Überblick
| Baustein | Aufgabe | Typische Werkzeuge | Häufigster Fehler |
|---|---|---|---|
| Parsing | Dokumente in sauberen Text | Docling, Unstructured | Tabellen und Scans gehen verloren |
| Chunking | Sinnvolle Abschnitte bilden | Überschriften-basiert | Feste Längen ohne Kontext |
| Embeddings | Bedeutung als Vektor | OpenAI, Mistral, lokale Modelle | Modell ohne Test gewählt |
| Speicher | Vektoren plus Metadaten | Qdrant, pgvector, ChromaDB | Keine Rechte in den Metadaten |
| Retrieval | Passende Chunks finden | Hybrid Search, BM25 | Nur Vektorsuche |
| Reranking | Beste Treffer nach oben | Cross-Encoder | Fehlt ganz |
| Generierung | Antwort mit Quelle | GPT, Claude, Mistral, Llama | Keine Regel für „weiß ich nicht“ |
| Evaluation | Qualität messen | Testset, Ragas, LLM-as-a-Judge | Wird erst nach dem Go-live gedacht |
Die Tabelle zeigt, was uns der im März 2026 versehentlich veröffentlichte Quellcode von Claude Code auch für Coding-Agenten bestätigt hat: Ein erfolgreiches KI-System besteht zum allergrößten Teil aus klassischer Software. Bei Claude Code waren es rund eine halbe Million Zeilen TypeScript für Kontextverwaltung, Fehlerbehandlung, Werkzeuge und Orchestrierung rund um das Modell. Bei einem RAG-System ist es genauso. Das Sprachmodell ist eine Zeile in der Tabelle, die anderen sieben entscheiden über die Qualität.
RAG, Fine-Tuning oder Long Context?
Nicht jedes Wissensproblem braucht ein RAG-System. Die drei gängigen Wege im Vergleich:
| Ansatz | Passt, wenn | Aktualität | Aufwand |
|---|---|---|---|
| Long Context | Wissensbasis bis ca. 500 Seiten | sofort | gering |
| RAG | Große, sich ändernde Bestände | nach Re-Index | mittel |
| Fine-Tuning | Stil, Format, Fachsprache | nach Training | hoch |
Long Context bedeutet, die gesamte Wissensbasis einfach mit in den Prompt zu geben. Anthropic empfiehlt das ausdrücklich für Bestände unter etwa 200.000 Tokens, rund 500 Seiten. Mit Prompt-Caching bleibt das bezahlbar, und es entfallen alle Fehlerquellen der Suche. Für ein Produkthandbuch oder einen Satz Richtlinien ist das oft die bessere Lösung.
Fine-Tuning verändert das Modell selbst. Es eignet sich, um einem Modell einen Stil, ein Ausgabeformat oder Fachsprache beizubringen, aber kaum, um ihm Fakten zuverlässig zu merken. Für Firmenwissen, das sich ändert und belegbar sein muss, ist es fast nie die erste Wahl.
RAG ist richtig, sobald der Bestand zu groß für den Kontext wird, sich regelmäßig ändert, aus mehreren Quellen kommt oder unterschiedliche Leserechte hat. Das ist bei Intranets, technischer Dokumentation, Support-Wissen und Vertragsbeständen fast immer der Fall.
Was kostet ein RAG-System?
Die gute Nachricht zuerst: Das Modell ist selten der Kostentreiber. Embeddings sind extrem günstig. Das verbreitete Modell text-embedding-3-small von OpenAI kostet laut gängigen Preisübersichten 0,02 US-Dollar pro einer Million Tokens (Stand Oktober 2026). Eine Wissensbasis mit 10.000 Seiten lässt sich damit für deutlich unter einem Euro einmal komplett indexieren.
Auch die laufenden Kosten pro Frage sind überschaubar. Bei Logify, unserer KI-Logfile-Analyse für den IT-Support, die per RAG rund 500 MB technische Dokumentation durchsucht, liegen die Modellkosten bei rund einem US-Dollar pro 100 Abfragen. Je nach Modell, Länge des mitgegebenen Kontexts und Zahl der Prüfschritte kann das deutlich nach oben oder unten abweichen.
Das eigentliche Budget fließt in drei andere Posten:
- Datenaufbereitung: Dokumente finden, bereinigen, Dubletten und veraltete Versionen aussortieren, Scans und Tabellen lesbar machen. In vielen Projekten ist das der größte Einzelposten.
- Evaluation: Ein Testset aus echten Fragen mit belegten Antworten aufbauen und jede Änderung daran messen. Ohne das bleibt jede Optimierung Bauchgefühl.
- Integration und Betrieb: Anbindung der Quellsysteme, Rechteprüfung, Re-Indexierung bei Änderungen, Monitoring und Updates, wenn Modelle wechseln.
Als grobe Orientierung (Schätzung): Ein Proof of Concept auf einem abgegrenzten Dokumentenbestand ist in wenigen Wochen machbar. Ein produktives System mit mehreren Quellen, Rechten, Evaluation und Betrieb ist eher ein Projekt über mehrere Monate. Was danach im Betrieb passieren muss, beschreiben wir im Beitrag zur Hypercare-Phase.
Mit dem folgenden Check können Sie für Ihren Bestand grob abschätzen, welche Architektur passt und was die Modellkosten ausmachen:
Interaktiv
RAG-Check: Architektur und laufende Kosten
Geben Sie grob ein, wie groß Ihre Wissensbasis ist und wie oft sie genutzt wird:
Grobe Schätzung. Annahmen: rund 400 Tokens pro Seite, Embedding-Preis 0,02 US-Dollar pro 1 Mio. Tokens (text-embedding-3-small, Stand Oktober 2026), vereinfacht 1:1 in Euro umgerechnet. Aufbau, Datenaufbereitung, Evaluation und Betrieb sind nicht enthalten, und genau dort liegt der größte Teil des Aufwands.
Die sieben typischen Fehler beim RAG-System
Die meisten RAG-Prototypen beantworten in der Demo zehn Fragen gut und scheitern dann an der elften. Die Ursachen sind fast immer dieselben.
1. Schlechte Dokumente rein, schlechte Antworten raus
Ein RAG-System kann nur finden, was sauber im Index steht. Word-Dateien in verstreuten Ablagen, PDFs mit Tabellen als Bild, fünf Versionen desselben Handbuchs: Das alles landet ungefiltert im Index und verwirrt die Suche. In unseren Projekten fließt deshalb viel Zeit in die Aufbereitung, bevor der erste Chunk entsteht. Das war schon bei IntranetGPT so, einem RAG-Chatbot, der verteiltes Intranet- und Richtlinienwissen per Chat zugänglich macht und laut interner Kommunikation des Kunden bis zu 70 Prozent kürzere Suchzeiten gebracht hat.
2. Chunks ohne Kontext
Ein Abschnitt „Die Frist beträgt 14 Tage“ ist wertlos, wenn das System nicht weiß, aus welchem Vertrag und welchem Kapitel er stammt. In den Labs unserer RAG-Advanced-Schulung stieg die Trefferquote auf Platz 1 (Hit@1) bei schwierigen Fragen von 0,692 auf 0,846, nur weil jeder Chunk den Pfad seiner Überschriften mittrug. Gemessen auf dem Kurs-Datensatz, übertragbar ist die Richtung, nicht die genaue Zahl.
3. Nur Vektorsuche
Vektorsuche versteht Bedeutung, ist aber schwach bei exakten Begriffen wie Artikelnummern, Fehlercodes oder Paragrafen. Hybrid Search kombiniert sie mit klassischer Stichwortsuche (BM25). Anthropic hat für seine Methode „Contextual Retrieval“ im September 2024 gemessen, dass kontextangereicherte Embeddings plus Stichwortsuche die fehlgeschlagenen Suchen um 49 Prozent senkten, mit zusätzlichem Reranking um 67 Prozent. Das sind Werte aus Anthropics eigenen Benchmarks, sie schwanken je nach Datenart deutlich.
4. Kein Reranking
Die Suche liefert die 20 bis 50 ähnlichsten Chunks, das Sprachmodell braucht aber die besten drei bis acht. Ein Reranker bewertet jeden Kandidaten noch einmal gezielt gegen die Frage. In unseren Schulungs-Labs stieg Hit@1 damit von 0,917 auf 0,950. Der Preis: Die Latenz wuchs von 9 auf 222 Millisekunden. Ob sich das lohnt, ist eine Abwägung, die Sie messen sollten, nicht schätzen.
5. Keine Rechte im Retrieval
Der gefährlichste Fehler: Ein Chatbot, der jedem Mitarbeitenden die Gehaltsrichtlinie der Geschäftsführung zitiert, weil alle Dokumente in einem Index liegen. Berechtigungen müssen als Metadaten an jedem Chunk hängen und bei jeder Suche gefiltert werden, bevor das Modell den Text sieht. Nachträglich lässt sich das kaum sauber einbauen.
6. Kein Testset
Ohne eine Sammlung echter Fragen mit belegten Antworten wissen Sie nicht, ob eine Änderung das System besser oder schlechter macht. Mit einem Testset prüfen Sie jede Änderung an Chunking, Modell oder Prompt automatisch, idealerweise als Regressionstest in der CI/CD-Pipeline. Wie Sie dafür gute Testdaten aufbauen, zeigt unser Beitrag zu Ground-Truth-Daten in RAG-Systemen, Hintergründe zur Methode finden Sie im Glossar unter Evaluation.
7. Keine erlaubte Nicht-Antwort
Ein Modell, das immer antworten soll, antwortet auch dann, wenn die gefundenen Stellen nicht passen. Gute RAG-Systeme haben eine klare Regel: Wenn die Quellen die Frage nicht beantworten, sagt das System das und verweist an einen Menschen. Für Antworten mit Folgen gehört zusätzlich eine Freigabe durch einen Menschen in den Prozess.
Wie gehen Sie beim Aufbau eines RAG-Systems vor?
Aus unseren Projekten hat sich ein Vorgehen in sechs Schritten bewährt:
- Anwendungsfall und Fragen sammeln. Welche Fragen sollen beantwortet werden, von wem, wie oft? 50 bis 100 echte Fragen aus dem Alltag sind der beste Startpunkt und gleichzeitig der Kern Ihres späteren Testsets.
- Quellen und Rechte klären. Welche Dokumente sind maßgeblich, wo liegen sie, wer darf was sehen? Ohne diese Antwort sollte keine Zeile Code entstehen.
- Größe prüfen. Passt alles in den Kontext, starten Sie mit Long Context. Erst wenn nicht, bauen Sie die RAG-Pipeline.
- Einfach starten, dann messen. Saubere Aufbereitung, Chunks mit Kontext, Hybrid Search. Dann am Testset messen, wo das System scheitert: beim Finden oder beim Formulieren.
- Gezielt verbessern. Reranking, Query-Rewriting oder ein anderes Embedding-Modell nur dort, wo die Messung einen Engpass zeigt.
- Betrieb planen. Re-Indexierung bei Änderungen, Monitoring der Antworten, Kostenkontrolle und ein Meldeweg für falsche Antworten.
Für Agenten, die nicht nur Dokumente lesen, sondern auch mit Systemen arbeiten sollen, wird RAG oft mit Werkzeugen über das Model Context Protocol kombiniert. Dann sucht der Agent im Wissen und fragt gleichzeitig aktuelle Daten live ab. Wie so ein Agent aufgebaut ist, beschreibt unser Beitrag KI-Agent erstellen.
RAG-Chatbot und Datenschutz: Was ist zu beachten?
Ein RAG-System verarbeitet häufig personenbezogene Daten, etwa Namen in Protokollen, E-Mails oder Tickets. Damit gelten die üblichen Pflichten der DSGVO: Rechtsgrundlage, Auftragsverarbeitung mit dem Modellanbieter, Löschkonzept und Zugriffskontrolle. Der Vorteil von RAG gegenüber Fine-Tuning: Gelöschte Dokumente verschwinden mit dem nächsten Re-Index auch aus den Antworten, weil kein Wissen im Modell selbst steckt.
Für sensible Bestände gibt es zwei Wege. Entweder ein europäisches Rechenzentrum mit klaren Verträgen beim Modellanbieter, oder ein lokales LLM auf eigener Infrastruktur. Dazwischen liegt ein Mittelweg, den wir bei Logify gegangen sind: Seit April 2026 laufen Anwendung und Indexierung On-Premise auf der Infrastruktur des Kunden, das Sprachmodell selbst wird über die OpenAI-API angebunden. Die Architektur erlaubt es, das Modell später gegen ein lokales zu tauschen. Lokale Modelle sind heute für viele RAG-Aufgaben gut genug, weil sie nur formulieren müssen, was die Suche gefunden hat.
Einen guten, neutralen Überblick zum Thema bietet die Studie „Unternehmensdokumente erschließen mit RAG“ des Fraunhofer IAO vom März 2026, die kostenlos verfügbar ist.
Fazit
Ein RAG-System ist der direkteste Weg, KI mit dem Wissen Ihres Unternehmens arbeiten zu lassen, nachvollziehbar und ohne Ihre Daten in ein Modell zu trainieren. Die Technik ist ausgereift und die Modellkosten sind gering. Über Erfolg oder Misserfolg entscheiden die Datenqualität, eine Suche, die auch exakte Begriffe findet, Rechte auf Chunk-Ebene und ein Testset, das jede Änderung messbar macht. Prüfen Sie vor dem Bau außerdem ehrlich, ob Ihr Bestand nicht einfach in den Kontext passt.
Häufige Fragen
Was ist ein RAG-System?
Ein RAG-System (Retrieval-Augmented Generation) ist eine KI-Anwendung, die zu jeder Frage zuerst passende Textstellen aus den eigenen Dokumenten sucht und das Sprachmodell nur auf dieser Grundlage antworten lässt, meist mit Quellenangabe. So nutzt KI Firmenwissen, ohne dass ein Modell mit den Daten trainiert wird.
Was ist der Unterschied zwischen LLM und RAG?
Ein LLM ist das Sprachmodell selbst und kennt nur sein Trainingswissen. RAG ist eine Architektur um das LLM herum: Eine Suchkomponente liefert dem Modell bei jeder Frage die relevanten Stellen aus Ihren Daten. Das Modell formuliert die Antwort, die Fakten kommen aus Ihren Dokumenten.
Ist ChatGPT ein RAG-System?
ChatGPT selbst ist in erster Linie ein Chat auf Basis eines Sprachmodells. Funktionen wie die Websuche, hochgeladene Dateien oder angebundene Wissensquellen arbeiten aber nach dem RAG-Prinzip: Sie suchen passende Inhalte und geben sie dem Modell als Kontext. Ein eigenes RAG-System gibt Ihnen zusätzlich Kontrolle über Quellen, Rechte und Qualität.
Was kostet ein RAG-System?
Die Modellkosten sind meist gering: Embeddings kosten Bruchteile eines Cents pro Seite, eine Abfrage liegt oft im Bereich um einen Cent. Den Großteil des Budgets machen Datenaufbereitung, Evaluation, Integration und Betrieb aus. Ein Proof of Concept ist nach unserer Schätzung in wenigen Wochen machbar, ein produktives System mit Rechten und Monitoring eher in mehreren Monaten.
Brauche ich für RAG eine Vektordatenbank?
Für produktive Systeme in der Regel ja, weil sie Vektoren, Text und Metadaten wie Berechtigungen gemeinsam speichert und schnell durchsucht. Für kleine Prototypen reicht oft ein einfacher Index. Verbreitet sind Qdrant, pgvector als Erweiterung für PostgreSQL und ChromaDB. Wichtiger als das Produkt ist, dass die Datenbank Hybrid Search und Metadaten-Filter unterstützt.
Kann man ein RAG-System selbst bauen?
Einen Prototyp mit Frameworks wie LangChain oder LlamaIndex bauen technisch versierte Teams in wenigen Tagen. Der Schritt in den produktiven Betrieb ist der schwierige Teil: saubere Datenaufbereitung, Rechte im Retrieval, ein Testset zur Qualitätsmessung und Monitoring. Genau dort scheitern viele Eigenbauten.
RAG oder Fine-Tuning: Was ist besser?
Für Firmenwissen, das sich ändert und belegbar sein muss, ist RAG fast immer die bessere Wahl, weil neue Dokumente ohne Training verfügbar sind und Antworten Quellen nennen. Fine-Tuning eignet sich für Stil, Format oder Fachsprache. Für kleine Wissensbestände bis rund 500 Seiten kann auch Long Context ohne RAG ausreichen.
Sie möchten ein RAG-System auf Ihren eigenen Daten aufbauen oder einen bestehenden Prototyp in den produktiven Betrieb bringen? Wir prüfen gerne mit Ihnen, welcher Ansatz zu Ihrem Bestand passt. Einen Überblick über unsere Leistungen finden Sie unter Services, oder Sie buchen direkt ein unverbindliches Erstgespräch.
Deine Direktleitung zu unseren AI-Spezialisten
Erstgespräch buchen